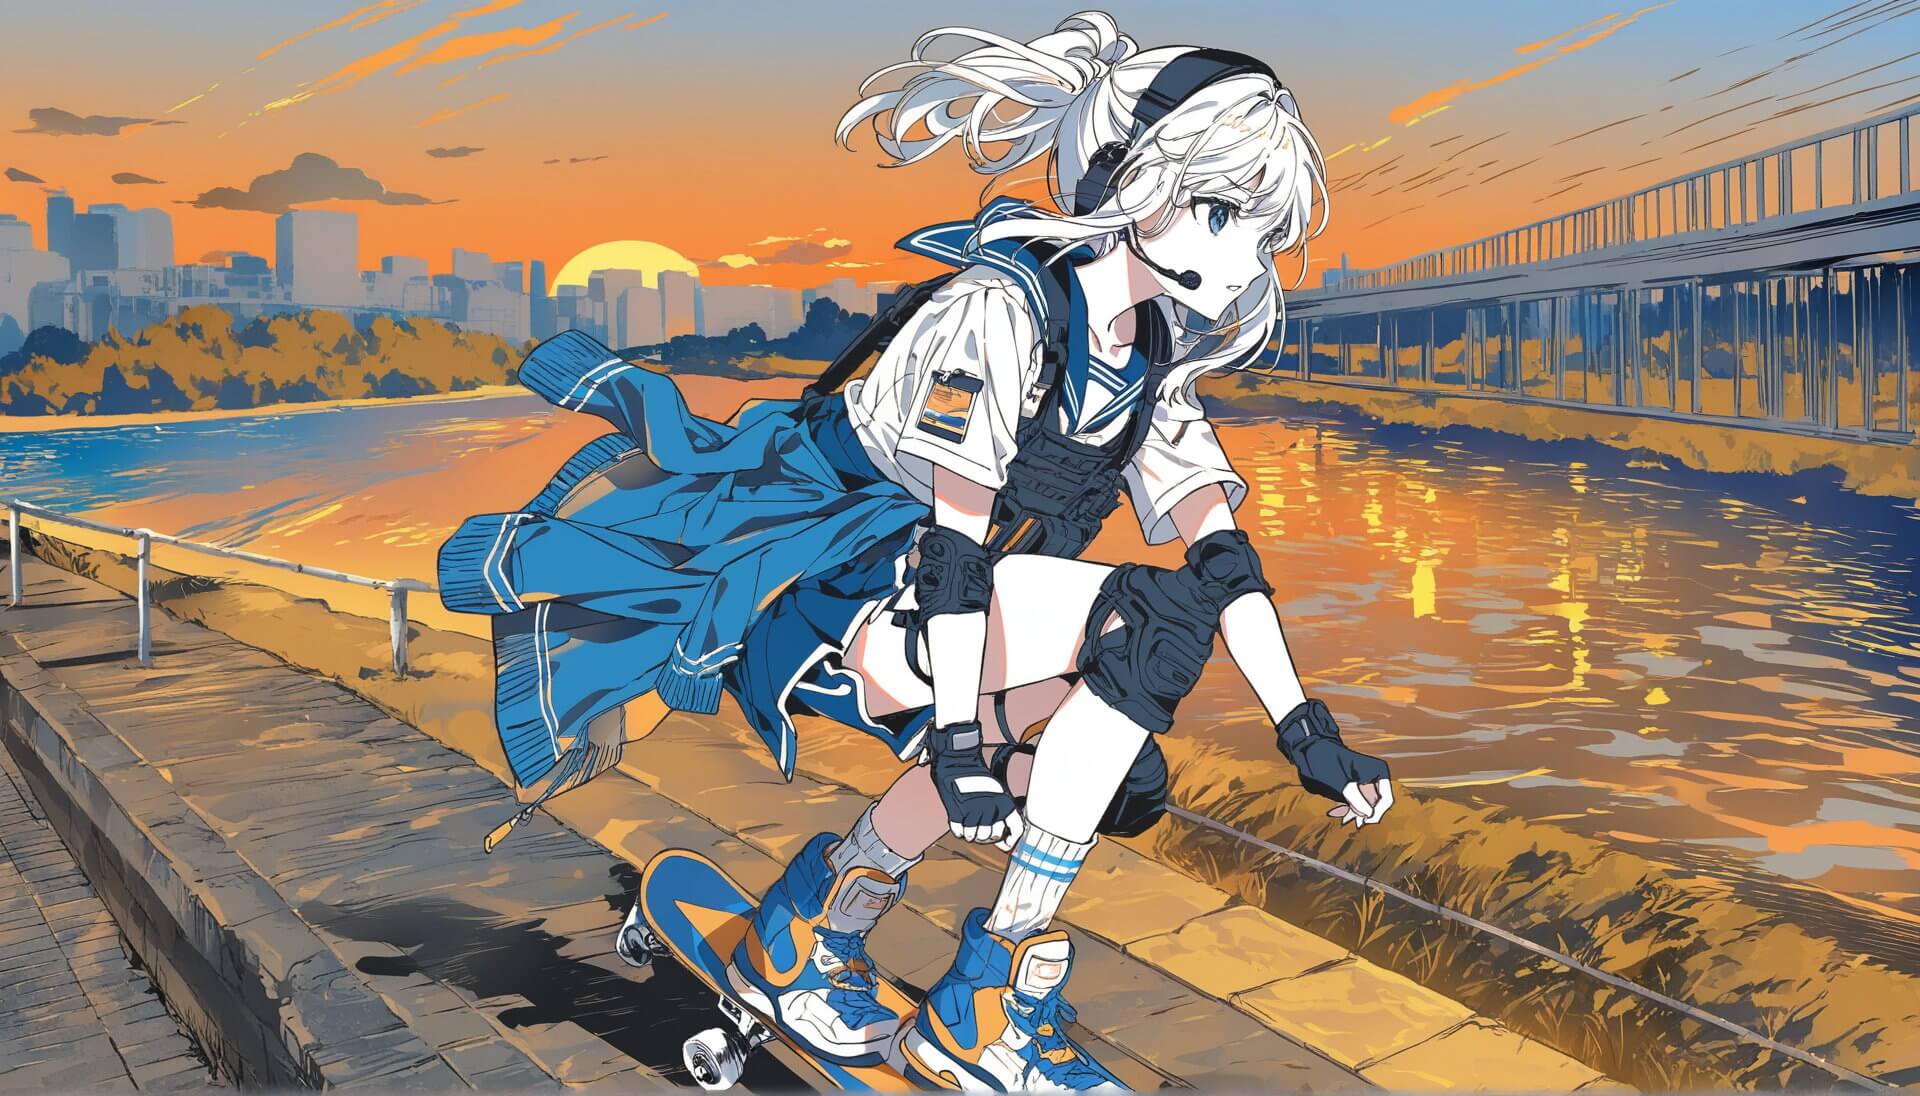
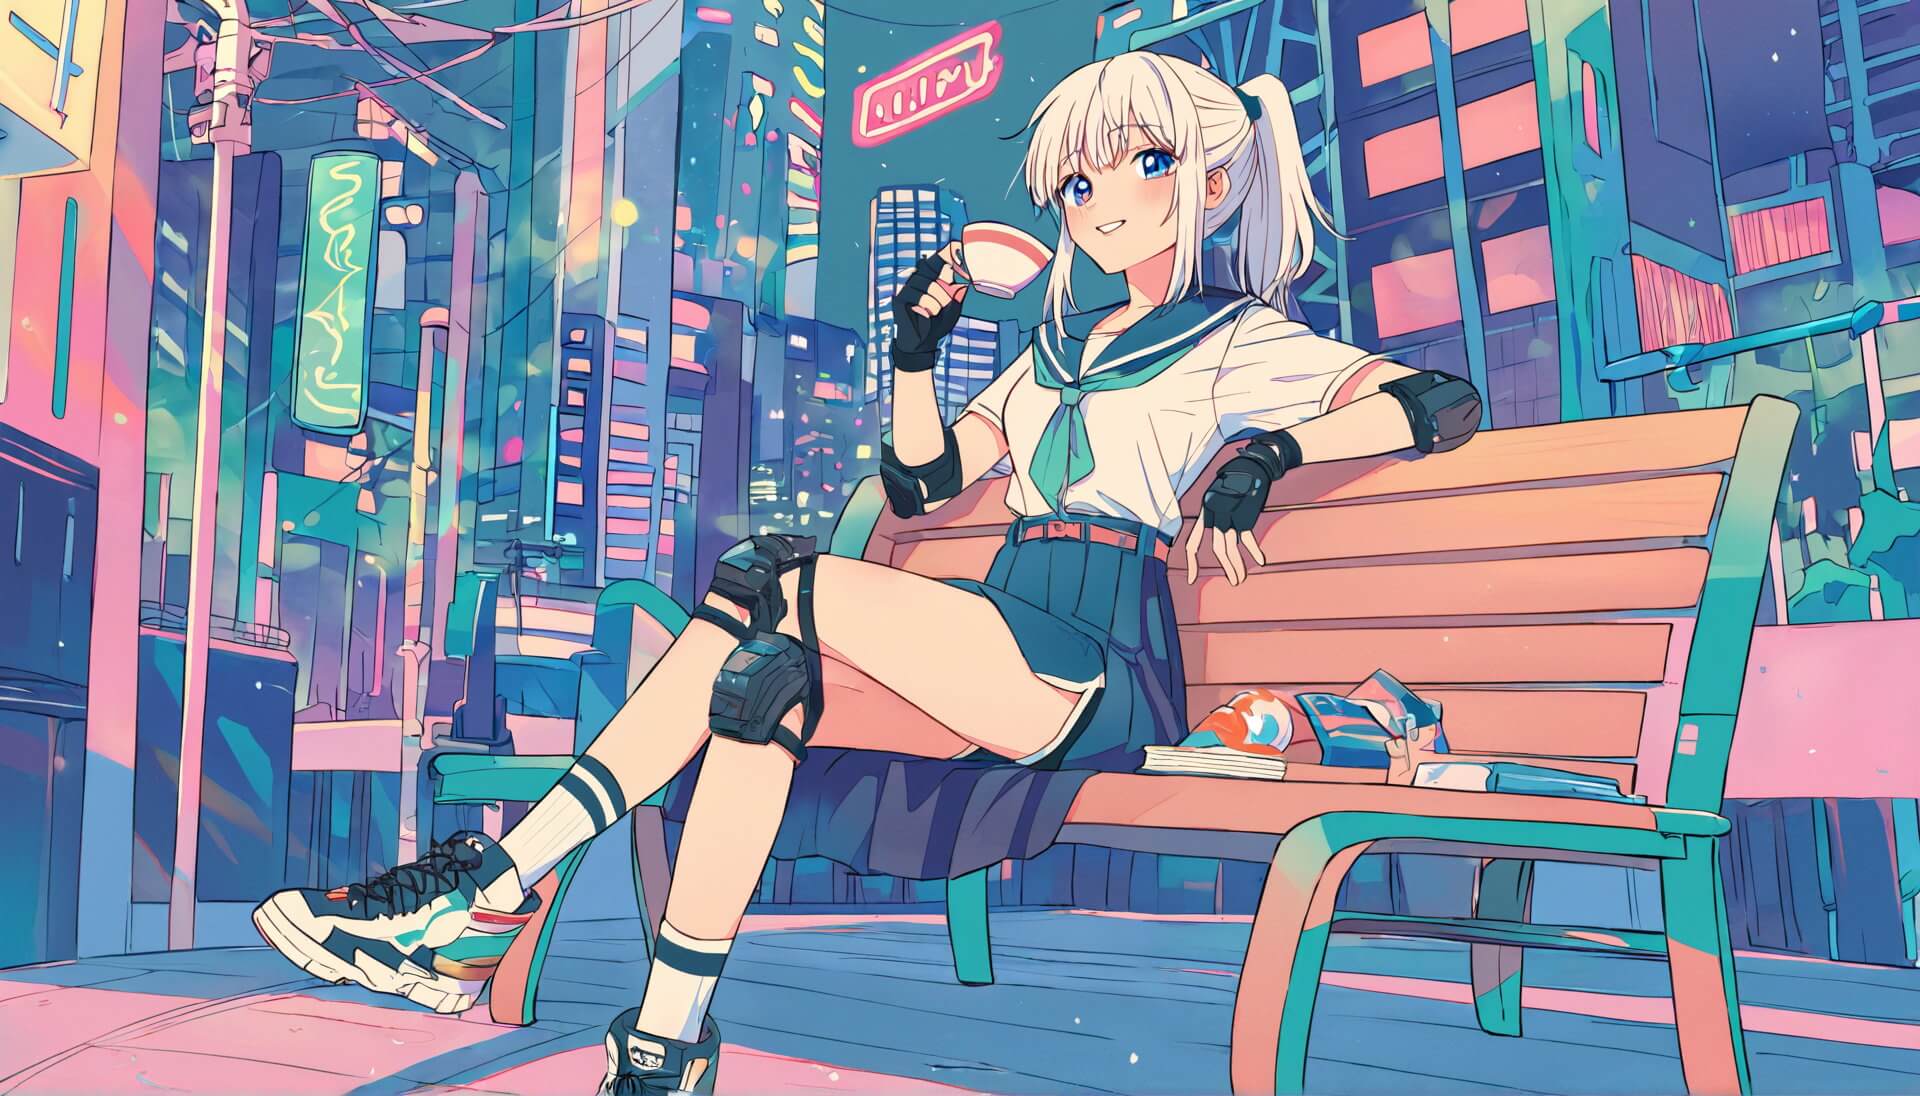
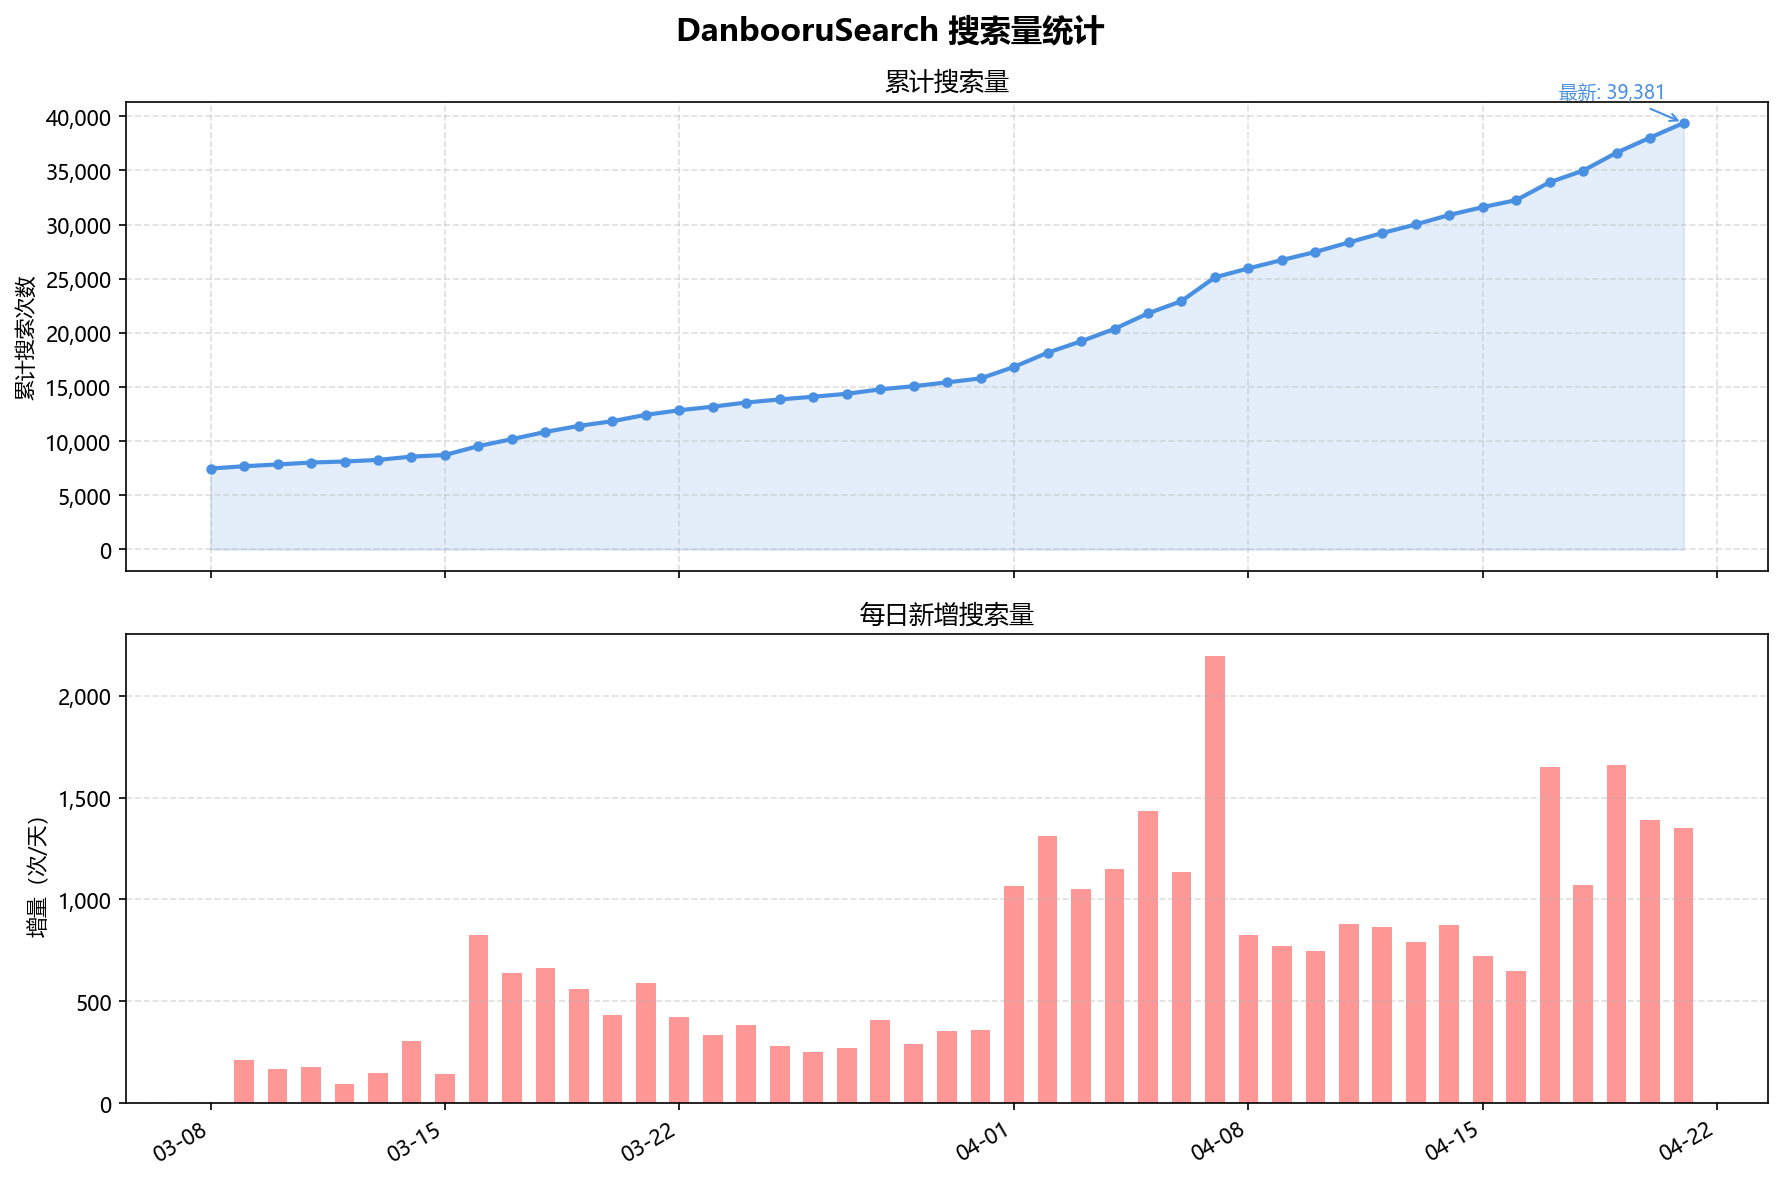
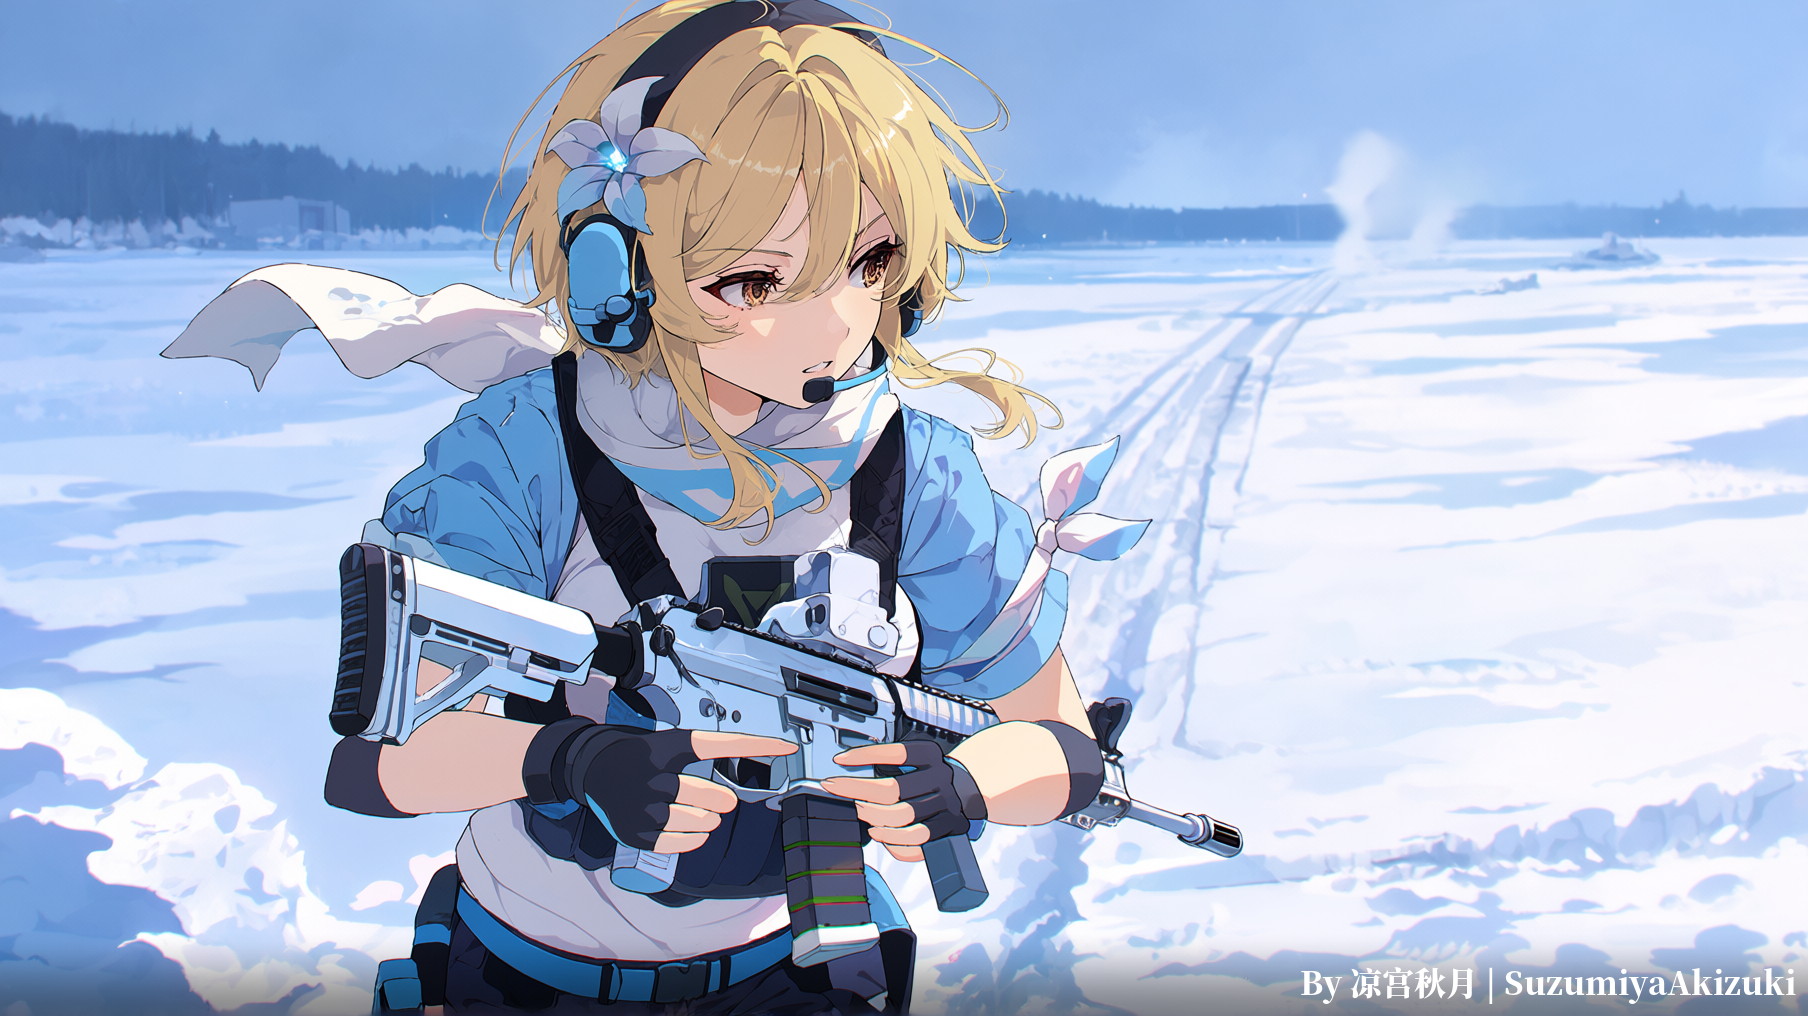
底层构建 4 个向量空间(英文、中文扩展词、维基释义、中文核心词),输入中文描述或英文模糊拼写均可精准命中。拼写错误、罗马音、词形变体自动容错。
长句自动拆分关键概念分别检索;也支持用空格、逗号、顿号手动分隔,每个片段作为原子概念匹配。≤7 字片段保持完整,>7 字自动回退分词。
基于 NPMI 共现统计,选中标签后自动推荐常一起出现的搭配标签。多标签取交集,精准定位特定场景下的专属搭配。
根据已选标签实时推荐擅长绘制这些元素的画师,按 NPMI 共现评分排序,画师可勾选加入已选标签。
知道大概写法但不确定拼写,或只记得部分写法。通过语义相似度而非字符串匹配,具备拼写容错能力。
建议参数: Top K: 10 | 结果上限: 10 | 热度权重: 0.15 | 关闭智能分词
| 输入 | 命中标签 | 说明 |
|---|---|---|
| selafuku | serafuku | 经典拼写错误 |
| twintail | twintails | 单复数混淆 |
| zettai ryouiki | zettai_ryouiki | 罗马音输入 |
脑中有模糊概念但不知道对应哪些标签,系统帮你「发散」出全部候选。输入「兔耳朵」返回真兔耳、头饰耳、兽娘耳等变体;输入「中国风古装」返回汉服、旗袍、各朝代服制。
建议参数: Top K: 80~160 | 结果上限: 80 | 热度权重: 0.15 | 开启智能分词
用自然语言描述具体事物,系统定位对应标签。支持通过剧情身份、人物关系、能力特征等模糊描述查找角色标签。
建议参数: Top K: 20 | 结果上限: 20 | 热度权重: 0.15 | 关闭智能分词
| 描述 | 命中角色 |
|---|---|
| 原神须弥主线的NPC贵族女孩 | dunyarzad_\\(genshin_impact\\) |
| 命运石之门的助手 | makise_kurisu |
| EVA 里驾驶零号机的蓝发角色 | ayanami_rei |
| 明日方舟里游戏商店的老板 | closure_(arknights) |
描述一整幅画面,自动拆词、分别匹配、合并去重,输出覆盖尽可能多画面元素的完整 prompt。
建议参数: Top K: 5 | 结果上限: 80 | 热度权重: 0.15 | 开启智能分词
输入示例:
一个穿着白色水手服、蓝色短裙的少女,在下着大雨的城市街道奔跑,
她的表情是不甘、愤怒、流泪,她的衣服湿透。
输出标签:short_dress city streaming_tears street white_serafuku furious rain running crying ...
不依赖语义相似度,而是基于 Danbooru 图库中标签的共现统计。NPMI 评分有效过滤仅因自身热度高而频繁出现的标签。 同时勾选多个标签时,综合计算多标签的共现关系,推荐与这组标签整体最匹配的标签。例如 maid + twintails 会倾向于「女仆且双马尾」场景下的专属搭配。
基于标签-画师 NPMI 共现数据。对每个已选标签计算与画师的共现分,累加后乘以命中标签数加权,归一化为百分比。画师可勾选加入已选标签(Anima 模式自动加 @ 前缀)。
| 参数 | 说明 | 建议值 |
|---|---|---|
| Top K | 每个分词语义召回的候选数量,值越大召回越广 | 精确查词 20,发散 80~160 |
| 结果上限 | 最终展示的标签总条数 | 70~80(适配 SDXL prompt 长度) |
| 热度权重 | 控制高频标签对排序的影响(0~1) | 0.15(默认) |
| 智能分词 | 自动拆分长句提取关键概念分别检索 | 完整画面开启,精确查词关闭 |
显式分隔符: 用空格、换行、中文逗号(,)和顿号(、)手动分隔概念时,每个片段作为原子概念匹配。超过 7 字的片段自动回退分词。
直接访问 HuggingFace Space,无需部署。支持中文和英文搜索,提供 NSFW 保护模式、维基释义悬浮提示、标签名跳转 Danbooru 原站。 HF Space 无流量时休眠,首次请求需等待冷启动(约 30~60 秒)。
标准 RESTful 接口,启动后访问 /api/docs 查看交互式文档。三个端点: POST /api/search — 自然语言搜索标签 POST /api/related — 共现关联推荐 POST /api/artists — 推荐擅长画师
接入 Claude Desktop、Cursor、Cherry Studio 等支持 MCP 的客户端。三个工具:search_tags、get_related_tags、get_artist_recommendations。
服务地址: https://sakizuki-danboorusearch.hf.space/mcp/mcp Claude Desktop 需通过 mcp-remote 桥接(npm install -g mcp-remote),图形界面客户端选择 Streamable HTTP 类型直接连接。
数据来源:Danbooru API 抓取,中文翻译与语义扩充由 LLM 辅助完成。角色名、作品名通过 Bangumi API 精确查询,避免幻觉。 仅收录频数 ≥100 的标签,覆盖 General(通用特征)、Character(角色)、Copyright(作品)三类。
数据库生成代码:github.com/SuzumiyaAkizuki/danbooru-tag-pipeline
先宽后窄:先用完整画面查找拿到大量候选,再勾选触发关联推荐补充遗漏细节。
悬浮查看释义:鼠标悬停在标签行上弹出 Danbooru 维基释义,无需跳转。
显式分隔精细控制:「运动社团 校队 比赛」每个概念原样保留;「反乌托邦、赛博朋克、废土」逗号分隔同理。
NSFW 保护模式:默认关闭,打开后标签完整名称和含义会显示出来。
基于个人博客内容的 RAG + Agent 系统,角色「秋枫」以猫娘女仆身份回答问题,支持引用原文溯源。
工具集:rag_search(本地检索)、fetch_context(扩展上下文)、web_search(Tavily 网络搜索)
查询重写:每轮都将用户问题经 DeepSeek 重写为 2~4 个关键词再分别检索。
与 DanbooruSearch 深度集成,通过 MCP 协议调用标签搜索引擎,将自然语言描述实时转化为 Danbooru 标签 prompt。
工具集:search_tags(标签搜索)、get_related_tags(关联推荐)、get_artist_recommendations(画师推荐)
Skill: Anima、Newbie模型的提示词书写Skill
查询重写:仅首轮且 query >10 字时重写,后续轮次直接使用原始查询。
双路召回:
向量检索 — ChromaDB 双 collection(content + title),权重 7:3
关键词检索 — BM25 + jieba 分词
多路融合:RRF(k=60)合并多个查询和多个召回通路的结果。
Multi-Query:用户问题先经 DeepSeek 重写为 2~4 个关键词再分别检索,扩大召回覆盖面。
相邻 chunk 扩展:fetch_adjacent() 供 fetch_context 工具使用,支持上下文溯源。
同步 Agent 通过 loop.run_in_executor 跑在线程池中,asyncio.Queue 桥接同步 Agent 到异步 FastAPI。
SSE 事件类型:
| 事件 | 说明 |
|---|---|
token |
逐 token 流式输出 |
token_flush |
已推送的 token 转为「思考过程」样式 |
tool_start |
工具调用开始 |
tool_done |
工具调用完成 |
answer |
最终答案 |
error |
错误信息 |
120 秒超时保护。
双端点自动切换:HF Space(主)+ ModelScope(备),调用失败自动切换。
连接管理:每次工具调用前重新握手(HF 多副本部署,session id 跨副本会 404)。
限流处理:429 限流时指数退避重试(5s → 10s → 20s,最多 3 次)。
工具定义:动态从 MCP tools/list 加载,失败回退硬编码 fallback。
Python 3.11 + FastAPI + DeepSeek(OpenAI 兼容 API)+ ChromaDB + BGE-M3 + BM25
配置来源:仅从环境变量(HF Secrets)获取,不支持配置文件。
| 环境变量 | 说明 |
|---|---|
DEEPSEEK_API_KEY |
API 密钥(必填) |
DEEPSEEK_BASE_URL |
API 地址(默认 deepseek.com) |
DEEPSEEK_MODEL |
模型名称(默认 deepseek-chat) |
TAVILY_API_KEY |
Tavily 网络搜索(可选) |
部署在 HF Space(Docker),端口固定 7860。两个 Agent 共用同一个 API Key。
LLM 在生成提示词的过程中调用 DanbooruSearch MCP 服务,实时搜索标签库,像人类一样查找、验证、补充标签,消除幻觉。
| 等级 | 行为 | 适用场景 |
|---|---|---|
| Close | 关闭 Agent,传统单轮 LLM 调用 | 已有完整标签、追求速度 |
| Low | 流水线模式:批量搜索 + LLM 直接组装,1 轮完成 | 追求最快速度 |
| Medium | Agent 循环:多轮迭代搜索,最多 8 轮 | 日常使用,平衡 |
| High | Agent 循环:宽召回 + 深探索,最多 10 轮 | 复杂场景、多人物 |
纯标签输入 1 轮直出;混合输入(标签 + 自然语言)自动划定搜索边界;支持单轮多工具并行调用。
NewBie 模式:生成结构化 XML 提示词,内置 lxml 自动修复。输出包含<character> <general_tags> 等语义化标签。
Anima 模式:生成 ## Prompt(标签块 + 英文自然语言段落)+ ## 中文解释(分点设计说明)的 Markdown 格式。标签分隔符为空格,画师使用 @ 前缀。
两种模式在节点内无缝切换,Agent 模式兼容两者。
支持传入图片,利用多模态大模型直接反推生成高精度提示词。这是让 LLM 反推提示词,而非图生图。
同一会话内微调提示词时(改发色、换画风、增删标签、调整权重),自动识别改动范围,只重做变化部分、复用其余结果,大幅减少等待时间和 Token 消耗。
完全相同的输入(仅标点、空格差异)直接返回上次结果,零等待、零消耗。Low(流水线)模式同样支持此提速。
核心格式化节点。输入自然语言或标签集,输出 NewBie XML 或 Anima 文本提示词。
输入参数:image(可选,多模态反推)、api_key、api_url、model_name、mode(NewBie/Anima)、thinking(深度思考开关)、agent_effort(Agent 等级)、user_text
输出:xml_out(NewBie: XML 提示词 / Anima: Prompt 部分)、text_out(NewBie: 额外说明 / Anima: 中文解释)
配置文件中的 api_key 和 api_url 优先于节点 UI 输入,防止 API Key 随工作流泄露。
将画师和风格信息注入到提示词中。支持 NewBie(XML)和 Anima(纯文本)两种模式。
输入:xml_input、mode、preset(预设风格)、artist_add(额外画师)、style_add(额外风格)
NewBie 模式:查找 XML 中 <artist> 和 <style> 标签并替换为预设内容。
Anima 模式:画师注入到质量词行之后(@画师名 格式),风格串追加到末尾。自动清洗括号、artist: 前缀、冒号权重等。
从当前提示词中自动提取 <artist> 和 <style> 标签,保存为新的风格预设到配置文件。仅支持从 XML 格式(NewBie 模式)提取,保存后的预设可在两种模式下使用。
| 字段 | 说明 |
|---|---|
api_key |
LLM API Key(强烈建议在此填写,非节点 UI) |
api_url |
API 主机地址,如 https://openrouter.ai/api/v1 |
model_list |
可用模型名称列表,显示在节点下拉框 |
system_prompt |
NewBie 模式系统提示词 |
system_prompt_anima |
Anima 模式系统提示词 |
gemma_prompt |
NewBie XML 输出前的固定引导词 |
fewshot_user/assistant |
NewBie 模式 Few-shot 注入 |
fewshot_user/assistant_anima |
Anima 模式 Few-shot 注入 |
artists_anima |
Anima 模式参考画师列表 |
styles |
预设风格提示词集合 |
从 LPF_config.json.example 复制并填写。配置文件值优先于节点 UI 输入。
深度思考适配平台:OpenRouter、DeepSeek、Google AI、Anthropic 官方、Kimi、小米 MIMO、Vercel AI Gateway。其他平台通过模型名称控制。
NSFW 破限:内置破限框架。非 Gemini 官方平台的 Gemini 模型有增强提示词。Gemini 官方平台不做强破限适配(加入强力破限词反而可能无输出)。
Gemini 兼容性:通过 OpenRouter 等网关使用 Gemini 时,自动处理并行工具调用兼容性问题。
Agent 模式下强制关闭深度思考,节省 Token。
自动重试:API 网络异常或格式异常时最多自动重试 3 次。
XML 自动修复:(仅 NewBie 模式)使用 lxml 对 LLM 输出的 XML 进行格式校验,检测到错误自动修复并在控制台打印差异。
Agent 自动降级:MCP 服务不可用时自动回退普通模式,不阻塞工作流。 死循环检测:自动检测重复工具调用,超过 3 次强制退出循环。
ComfyUI 集成:支持进度条显示、随时中断。
| 模型 | 平均成本/次 | NSFW | 质量 | 备注 |
|---|---|---|---|---|
| deepseek-v3.2 | ~$0.0008 | 均衡 | 均衡 | 综合性价比高 |
| gemini-3-flash | ~$0.0035 | 较好 | 最好 | NewBie 训练打标模型之一 |
| grok-4.1-fast | ~$0.0007 | 最好 | 较好 | NewBie 训练打标模型之一 |
| mimo-v2-flash | ~$0.0004 | 较好 | 一般 | — |
DeepSeek 注册赠 10 元额度,约可用 1000 次。以上价格参考 OpenRouter(均关闭思考模式)。
方法一(推荐):
comfy node install NewBie-LLM-Formatter
方法二:下载 ZIP → 解压到 ComfyUI/custom_nodes/ → 重命名 LPF_config.json.example 为 LPF_config.json → 填写配置 → 重启 ComfyUI
依赖:openai、lxml、numpy、Pillow、httpx
A:1girl,white_hair,blue_eyes, medium_hair, high_ponytail, small_breasts, sidelocks, parted_lips,serafuku,deep_blue_skirt, white_shirt, deep_blue_sailor_collar, short_sleeves, short_skirt, shirt_tucked_in, knee_pads, elbow_pads, fingerless_gloves, white_legwear, ankle_socks,striped socks ,sport_socks, high-top_hiking_sneakers,white dolphin shorts, shorts_under_skirt,toned,tactical_clothes, load_bearing_vest, tactical_school_uniform,她的左腿是假肢(prosthesis,prosthetic_leg,single_mechanical_leg) B: 1girl,(blonde hair:1.2),blonde_eyes,hair between eyes,short hair,ahoge,twintails,short twintails,chinese_clothes,hanfu,short_hanfu, (jiaoling_ruqun:1.2),banbi,short_skirt,short_mamianqun,sash,red_sash,sidelocks,low twintails, fingerless gloves,beizi_(clothing),hairclip,tassel, A young woman with white long hair(A) wearing a pale pink chiffon shirt with a delicate ribbon bow at the neckline, paired with a dark gray high-waisted pleated skirt, standing outside fitting room, shy expression with blushing cheeks, silver hair draping over shoulders, hands nervously holding dress hem. Another blonde woman(B) standing nearby with amazed and loving expression. Modern clothing store interior, soft lighting, anime style, beautiful, detailed, masterpiece 【请你按需修改她们的衣服提示词,以适配这个场景】
请你帮我设计一个日式西幻风格的美少女冒险家的人物设定,并为她生成一个能体现其魅力的动作和场景,为我生成完整Anima提示词。要求: 1. 人物的主要特征是活泼、元气,穿短裙、半指手套、靴子,带护具 2. 画面风格为mika pikazo风格的夸张色彩与动感动作 3. 构图以人物为主体,近景
平时用 AI 画图时,你是否也遇到过这些烦恼:想让两个角色一左一右坐着喝茶,AI 却总是把她们画重叠或搞混衣服特征;想做一张带标题的海报,却很难用文字说清标题、副标题和人物各自该放在哪个角落;面对长串的英文标签和复杂的坐标数字,不知从何下手。
MOSS 在线画板正是为了解决这些问题而设计的。你不需要背诵任何英文标签,也不用自己计算像素坐标——只需要在画布上像搭积木一样拉出几个方框,或者直接用中文把想法告诉右侧的 AI 助手「秋枫」,就能轻松定好画面构图、自动生成全套专业提示词。
从秋月空间首页点击 「MOSS 在线画板」(或直接访问 /moss),你会看到一个分为上、左、中、右四个区域的工作台(手机访问时可通过顶部的「画布 / 属性 / AI 对话」标签随时切换):
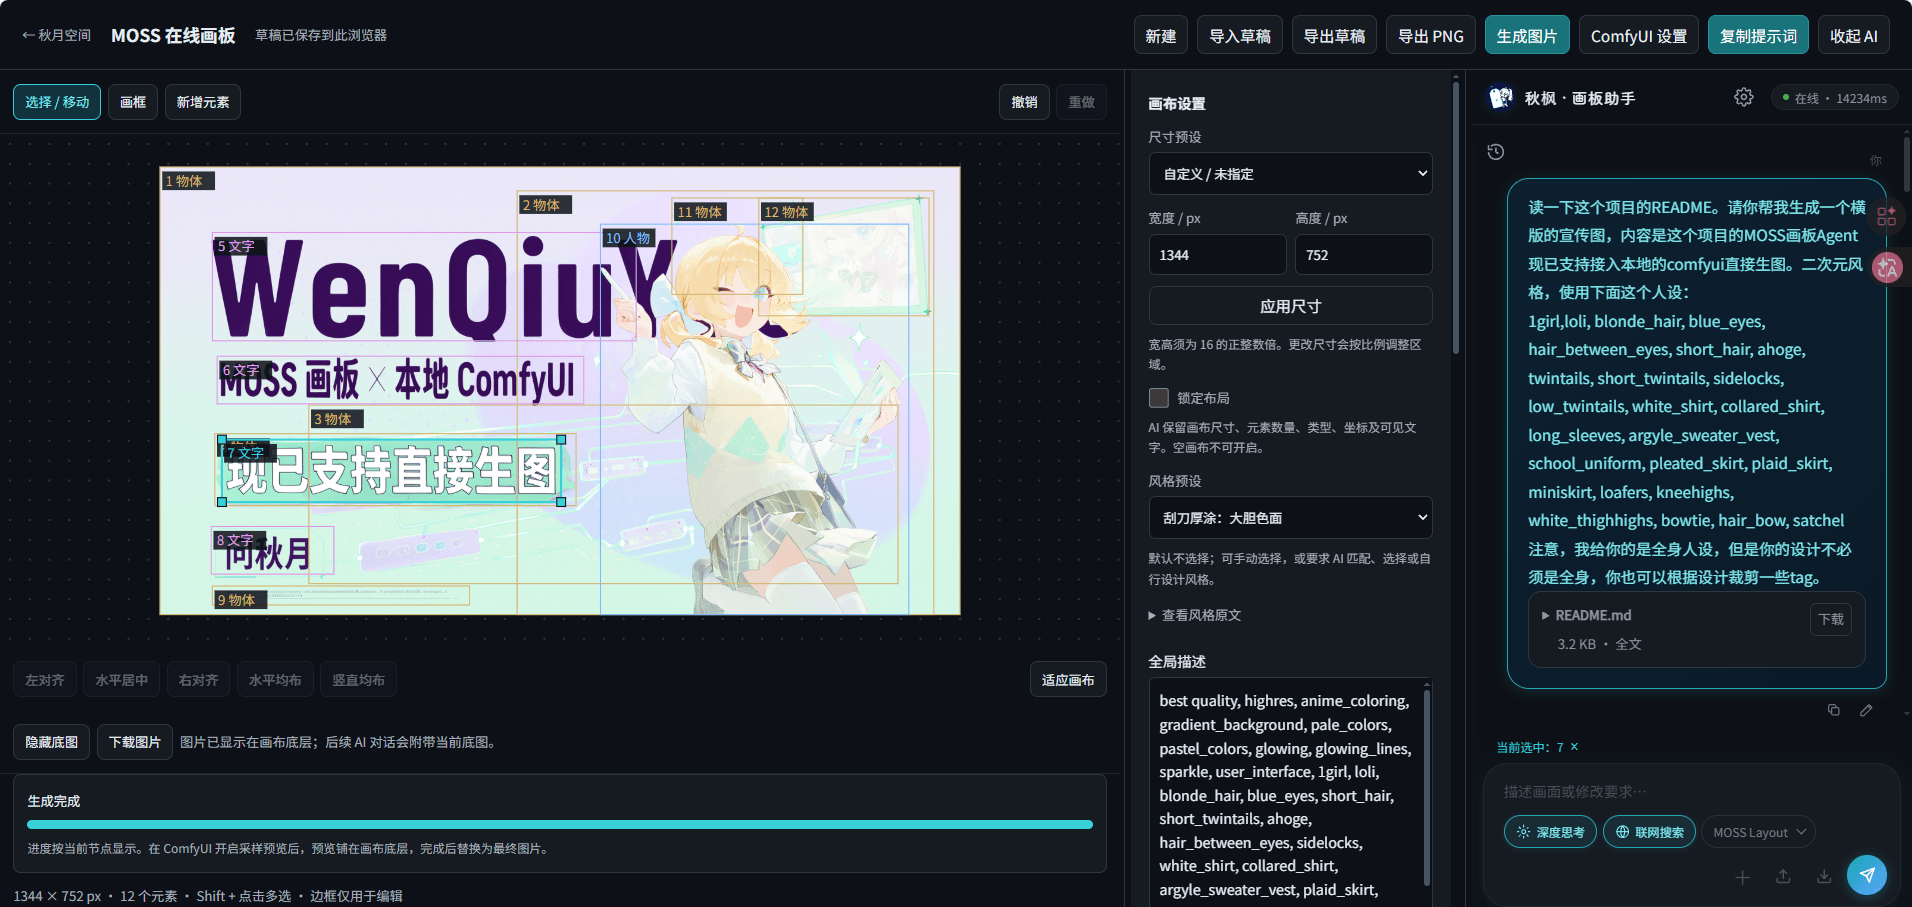
左、中、右三栏之间的两条竖线都可以用鼠标左右拖动,自由调整面板宽窄,不会影响画布本身的像素尺寸。
如果你脑子里只有一个画面想法,连画布设多大、方框怎么摆都不想操心:
1. 直接发消息:在右侧聊天框告诉秋枫你想画什么。例如:
2. 秋枫全自动编排:无需提前设置尺寸。秋枫会自动按用途计算合适的画布宽高,去标签库搜索准确的英文绘画标签,挑选契合的画风,把人物、物体、文字方框整齐摆到画布上,还会自动截图检查排版是否合理。 3. 随手微调:等秋枫排好后,所有方框都会呈现在左侧画布上。觉得哪个框偏了一点,直接用鼠标拖一拖就能改。
如果你对构图有明确想法(比如想还原某张海报的版式):
1. 设定画布大小:在中栏「画布设置」里选一个常用尺寸预设(如横版 1280 × 720 或方形 1024 × 1024),或手动输入宽高(数字需为 16 的倍数,如 720、1024、1344),点击 「应用尺寸」。 2. 在画布上拉框:点击左上角的 「画框」 按钮,在画布上按住鼠标左键拖拽,拉出你想要的区域。 3. 标记类型与文字:在中栏下方把刚画好的框设为「人物」「物体」或「文字」。如果是文字框,在 「实际可见文字」 中填好想要显示在画面上的字(支持中文、英文和换行)。 4. 交给秋枫补全润色:在右侧对秋枫说:「按我摆好的位置,帮我补全所有区域的英文描述和标签。」
画布上的方框并不是死板的格子,它们可以重叠、嵌套、大框套小框。点击展开下方四个真实场景案例,把透明构图框叠在成图上,一眼就能掌握排框诀窍:
制作活动封面、宣传图或贺图时,可以把背景里的重要景物(如月亮)、前景人物和不同层级的标题分成独立的框。
排框诀窍: 把页眉小字、主标题、副标题分别建成独立的「文字」框,并在中栏填好各自要显示的文字原文。人物框和文字框稍微有一点交叠也没关系,画面反而更有前后层次感。
可以直接复制给秋枫的指令示例:
720×720,做一张方形封面。右上角是一轮弯月,右下方是戴耳机的金发少女;左上角写小字“WENQIUYUE · 问秋月 PRESENTS”,中间偏左分两行写手写体大标题“15 Billion Tokens”和“问秋月 · 壹佰伍拾亿词元”,底下再加一行小副标题。
画多个人物和丰富场景时,用大框定背景,再用小框锁定前景角色和桌面道具,角色之间就绝不会「串衣服」或「抢位置」。
排框诀窍: 4 物体 框住整扇大窗户和窗外云海,5 物体 框住最左边的书架;1 人物 和 2 人物 一左一右对坐;中间用 3 物体 单独框出桌上的茶壶和三层甜品架。
可以直接复制给秋枫的指令示例:
1280×720,画两位少女在窗边圆桌喝下午茶:左边金发双马尾少女端着茶杯,右边白发马尾少女托腮微笑,中间桌上放着茶具和甜点,背景是大窗户外的云海远山,最左边有木头书架。
当你想画拔刀、弹琴等精细动作,只用一个大人物框往往很难控制手部和武器的位置。这时可以把同一个人的不同部位拆开框定。
排框诀窍: 用 1 人物 控制整个人物的范围,里面再用 2 人物 框住头部表情、3 人物 框住握刀的右臂、4 人物 框住和服上身;同时用 5 物体 和 6 物体 精准标出刀柄和刀鞘的走向,外围加上 7 物体 铺满飘落的樱花。
可以直接复制给秋枫的指令示例:
帮我画一位白发红瞳的和服武士少女正在拔刀,用多个框把她的头部特写、右手握刀柄的动作、刀鞘走向分开控制,背景加上飘落的樱花瓣。
在大透视场景里,哪怕是远处航母甲板上的一团火光,或是船头一个小小的编号,都可以用小框精准锚定。
排框诀窍: 左半边用大框定住前景的战机座舱和女飞行员,右半边层层框出远处的海面航母、空中的战机群与极光、甲板上的爆炸火光,并在航母船头放一个小小的 4 文字 框。
可以直接复制给秋枫的指令示例:
1280×720,第一视角战机座舱内坐着白发女飞行员,右侧窗外下方海面是一艘正在遇袭起火的航母,空中还有战机群与极光;在航母舰艏位置留一个微小文字区域。
想改某个人的动作或某行字,又怕 AI 把其他已经排好的部分乱改一通?
Shift 键可点选多个,也可以在中栏元素列表里打勾)。这时右下角聊天输入框上方会出现一行提示:当前选中:X ×。×,或在画布空白处点一下取消选中,即可回到修改整张画面的状态。如果你已经把所有方框的位置、大小和文字内容调得非常满意,只想让秋枫帮你换个画风,或者把英文描述写得更细腻:
不知道怎么用语言形容想要的画风和配色?
#ff99aa, skyblue),输入框下方会立刻显示出直观的彩色小色块。
如果不在本机跑图,只需点击顶部工具栏醒目的 「复制提示词」 按钮:
.txt 文件)。如果你自己电脑上装了 ComfyUI,可以把在线画板和本机 ComfyUI 连起来。点一下顶部 「生成图片」 就能直接出图,生成的图会自动铺在画布方框的正下方,方便你对照着画面继续微调。
最方便的是:只要画布底下显示着生成的图片,你接着在右边跟秋枫对话时(使用支持看图的 AI 模型),秋枫也能亲眼看到这张刚生成的图!你可以直接指着画面对她说:
交换一下她两只手的动作,靠近屏幕的这只手整理额前碎发,远离屏幕的那只手自然下垂。
秋枫就会对照实际生图效果,精准帮你调整对应方框的描述或位置。
点击顶部工具栏的 「ComfyUI 设置」 打开配置窗口(只需首次设置一次):
1. 填地址与添加跨域启动参数:
2. 导入 API 工作流:
3. 核对节点绑定与高级参数:
http://127.0.0.1:8188。--enable-cors-header "https://..." 的参数),把它加到你平时启动本机 ComfyUI 的命令末尾,然后重启 ComfyUI。若浏览器询问「是否允许访问本地网络」,请选择允许。除了在线网页版,如果你安装了配套的 ComfyUI-NewBie-LLM-Formatter 插件,也可以直接在 ComfyUI 的工作流画布中添加「MOSS 布局画布」节点,在节点内体验同样顺滑的手工拉框与 Agent 辅助排版:
Shift 选中 2 个以上方框,即可使用 「左对齐」「水平居中」「右对齐」;选中 3 个以上方框,即可使用 「水平均布」「竖直均布」,排列多行文字或分镜格时瞬间整整齐齐。Ctrl + Z),或点击秋枫聊天回复下方的 「撤销本次修改」,即可一键退回原样。.json 文件,下次点击 「导入草稿」 即可继续编辑。| 遇到的情况 | 原因说明 | 解决办法 |
|---|---|---|
| 点发送没反应,中栏下方出现红字提示 | 1. 处于局部修改状态(只选中了部分方框),但画布上还有未选中的空方框没填描述;<br>2. 勾选了「锁定布局」,但画布上有「文字」框还没填实际可见文字。 | 按中栏红字提示补齐空缺的描述或文字;或者先点画布空白处取消选中、取消勾选「锁定布局」再发送。 |
| 点击「复制提示词」提示无法导出 | 画布还没设宽高、全局描述为空、没有任何方框,或某个方框漏填了描述/可见文字。 | 看一眼中栏底部的提示文字,缺哪项补哪项(或直接让秋枫帮你补全),再点击复制即可。 |
| 修改画布尺寸后,原来的生成底图不见了 | 生成的底图与当时的画布构图尺寸绑定,改变尺寸比例后为防止画面变形会自动隐藏。 | 把画布尺寸改回生成该图时的宽高,底图就会重新显示;或者在新尺寸下重新点一次「生成图片」。 |
| 连接本地 ComfyUI 提示连接失败 | ComfyUI 未启动、未追加跨域启动参数重启,或浏览器拦截了本地网络访问权限。 | 确认本机 ComfyUI 正在运行,复制「ComfyUI 设置」里的启动参数加到启动命令末尾并重启 ComfyUI,同时在浏览器地址栏权限设置中允许「本地网络访问」。 |
| 秋枫提示任务暂停,让输入「继续」 | 画面要求非常细致,秋枫单轮搜索标签和调整画板的步骤达到了单次上限(17 步)。 | 前面的进度都已完整保留,直接在聊天框发送「继续」两个字,她就会接着把剩下的步骤做完。 |
下载链接:https://huggingface.co/SAkizuki/Anima-yoshinari-ko
本模型是一个基于 Anima 训练的 LoKR(Low-Rank Kronecker Product) 画风适配器,目标是捕捉《向山进发4》(Yama no Susume: Next Summit)BD 版 Non-Credit ED 动画截图中呈现的吉成鋼画风特征——手绘质感、水彩渲染、淡雅配色与柔和线条。
本模型使用 Anima Base v1.0 作为底模,训练集约 300 张来自《向山进发4》BD NCED 的动画截图,经 14 轮迭代训练而成。
请使用@yoshinari ko触发此画风,强度建议设置为0.5~1.5,过强的模型强度会对构图产生破坏。
模型规格
| 项目 | 详情 |
|---|---|
| 模型类型 | LoKR(Low-Rank Kronecker Product) |
| 底模 | Anima Base v1.0 |
| LoKR Rank | 64 |
| LoKR Alpha | 64 |
| LoKR Factor | 8 |
| Full Matrix | 是 |
| 训练精度 | FP16 |
| 输出格式 | SafeTensors |
训练参数
| 项目 | 详情 |
|---|---|
| 训练轮数 | 14 epochs |
| 批大小 | 2 |
| 梯度累积 | 2 |
| 优化器 | Automagic |
| 学习率 | 5×10⁻⁵(UNet) |
| 学习率调度 | Cosine with Restarts(3 个周期) |
| 预热步数 | 100 |
| 训练分辨率 | 1024×576 |
| 最小/最大 Bucket | 256 / 2048 |
| CLIP Skip | 2 |
| 扩散偏移 | 3(Shift) |
下载链接:https://huggingface.co/SAkizuki/Anima-Aniart
一款为Anima模型设计的手绘水彩风格LoKR,旨在复现"Ani-Art"独特的手绘、水彩和颜色漂移美学效果。
本模型使用 Anima Base v1.0 作为底模,训练集约 200 张来自Aniart网站的官方图,经 9 轮迭代训练而成。
请使用@aniart触发此画风,强度建议设置为0.5~1,过强的模型强度会对构图产生破坏。
模型规格
| 项目 | 详情 |
|---|---|
| 模型类型 | LoKR(Low-Rank Kronecker Product) |
| 底模 | Anima Base v1.0 |
| LoKR Rank | 64 |
| LoKR Alpha | 64 |
| LoKR Factor | 8 |
| Full Matrix | 是 |
| 训练精度 | FP16 |
| 输出格式 | SafeTensors |
训练参数
| 项目 | 详情 |
|---|---|
| 训练轮数 | 9 epochs |
| 批大小 | 1 |
| 梯度累积 | 1 |
| 优化器 | Automagic |
| 学习率 | 5×10⁻⁵(UNet) |
| 学习率调度 | Cosine with Restarts(3 个周期) |
| 预热步数 | 100 |
| 训练分辨率 | 512x512 |
| CLIP Skip | 2 |
| 扩散偏移 | 3(Shift) |
下载链接:https://huggingface.co/SAkizuki/anima-lumine_elemental_warfare
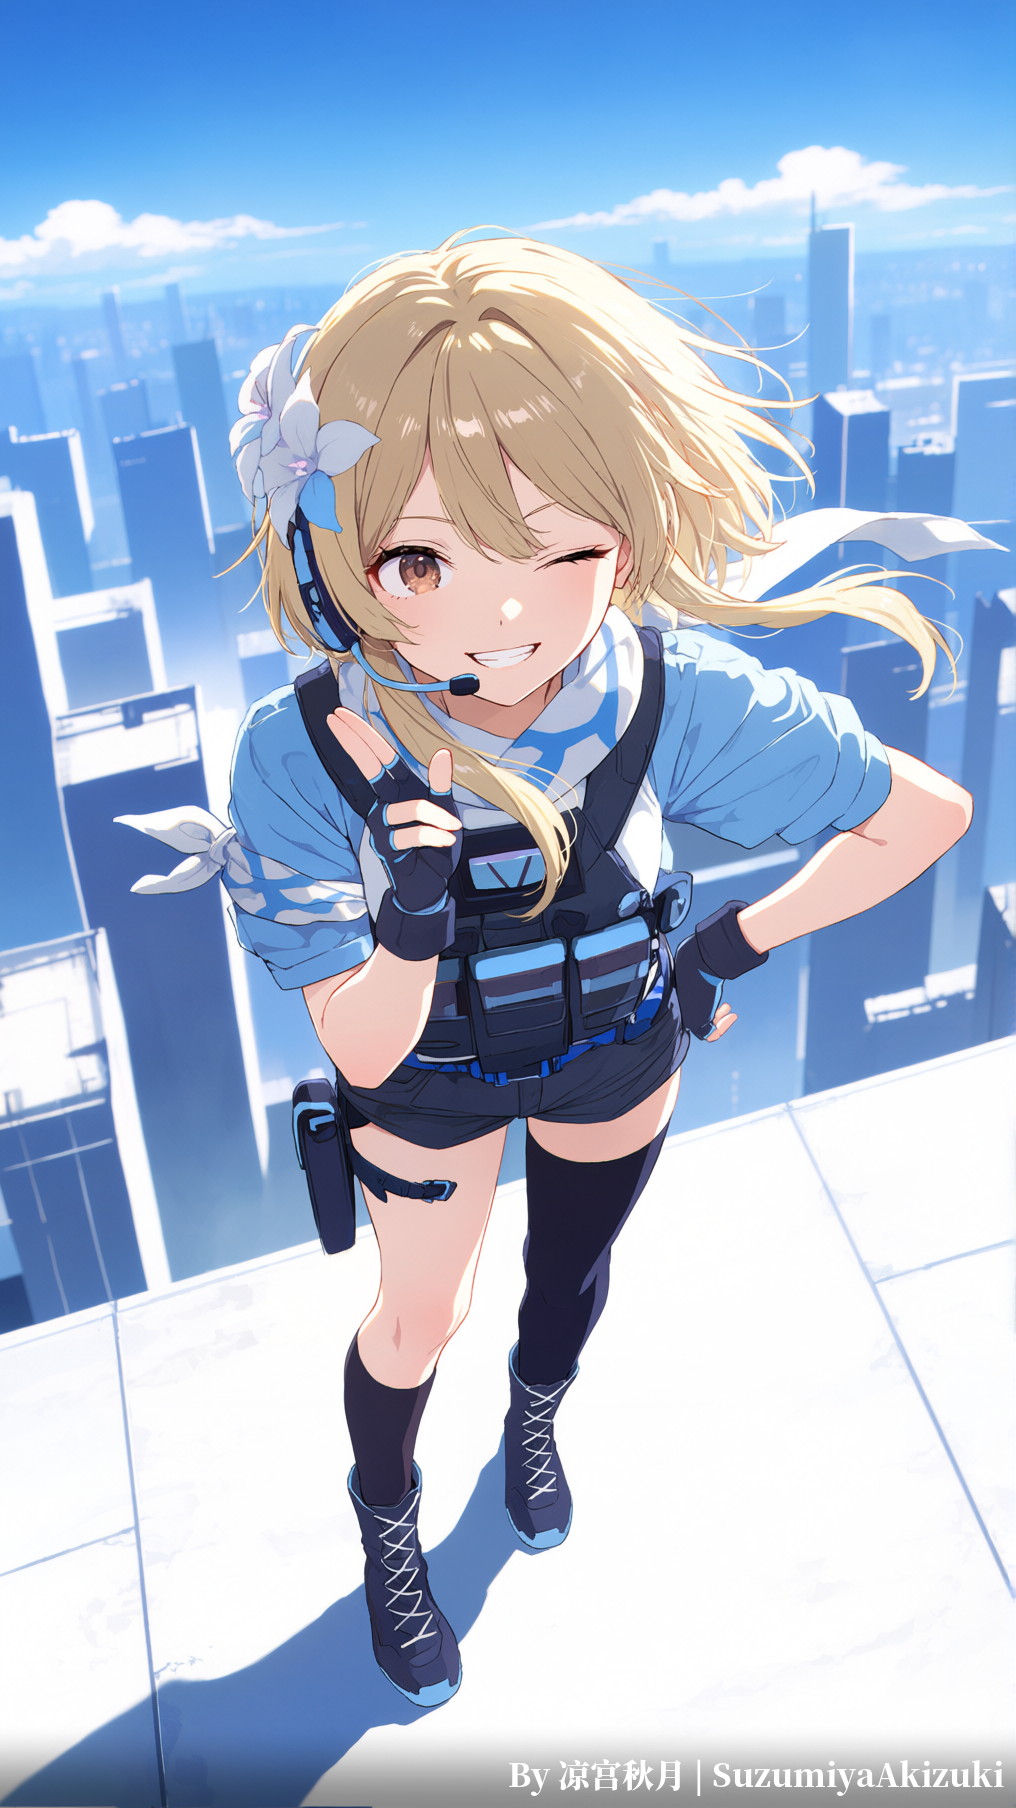
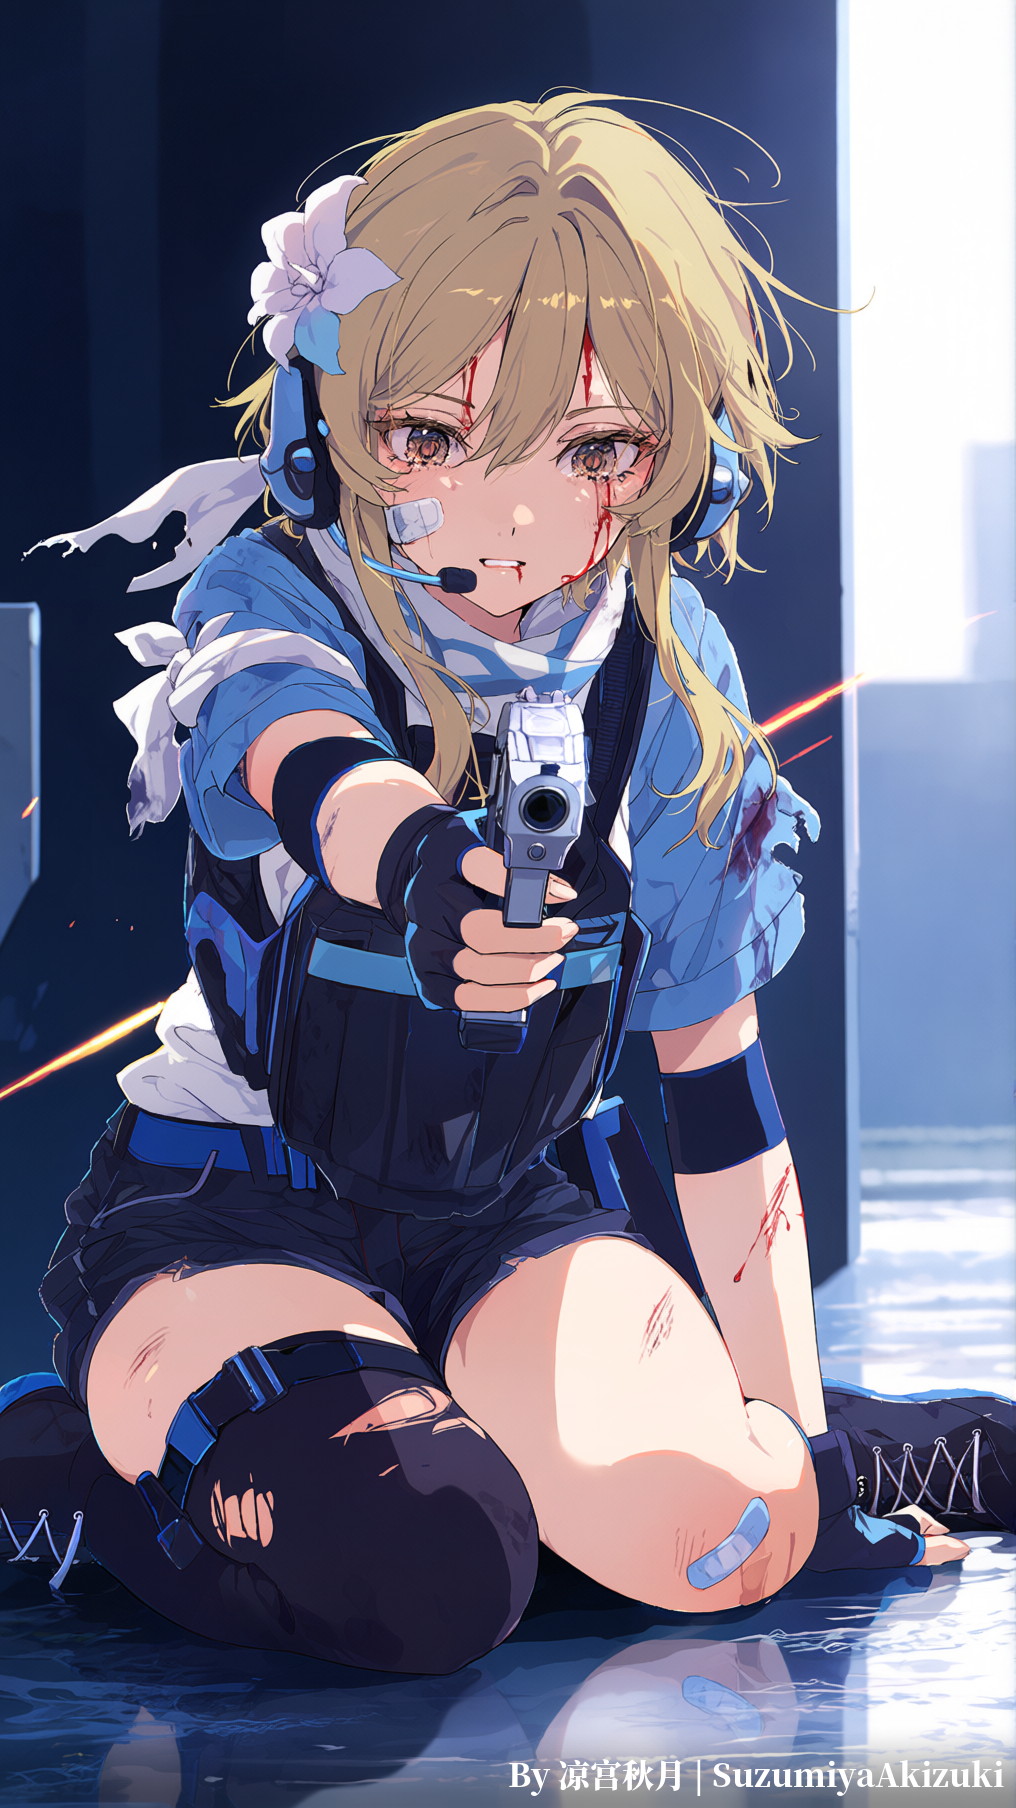
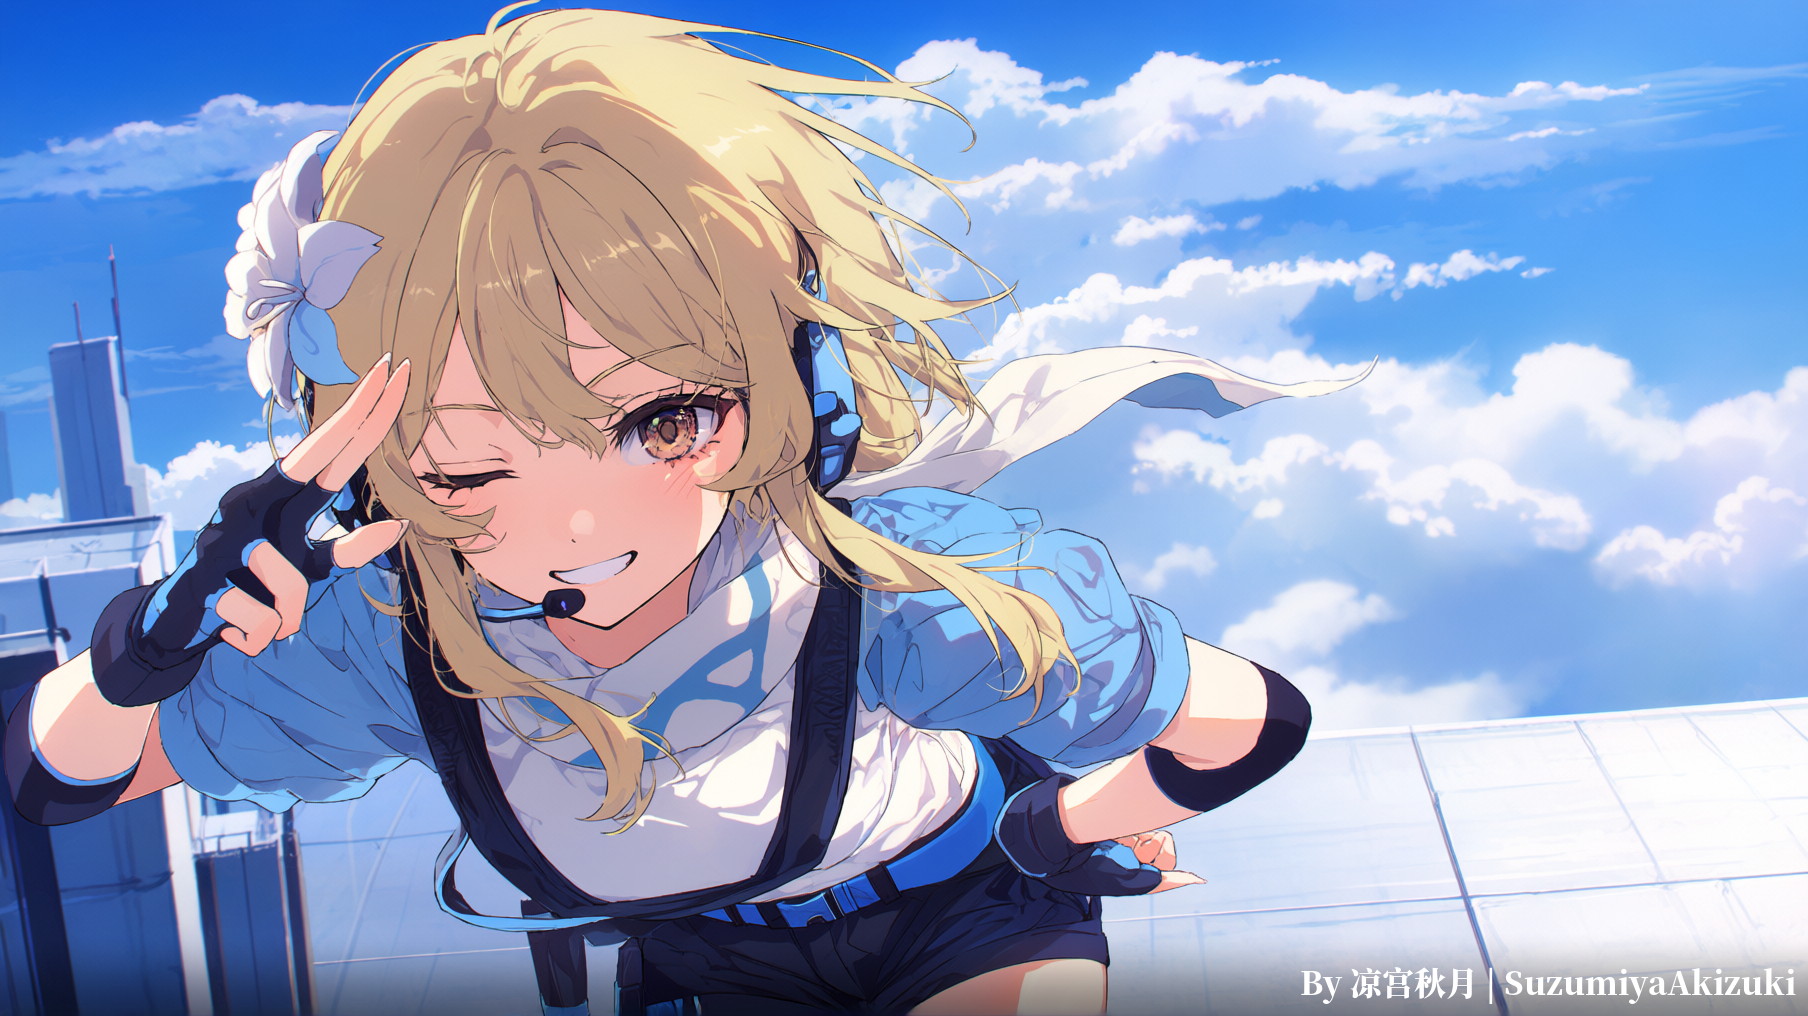
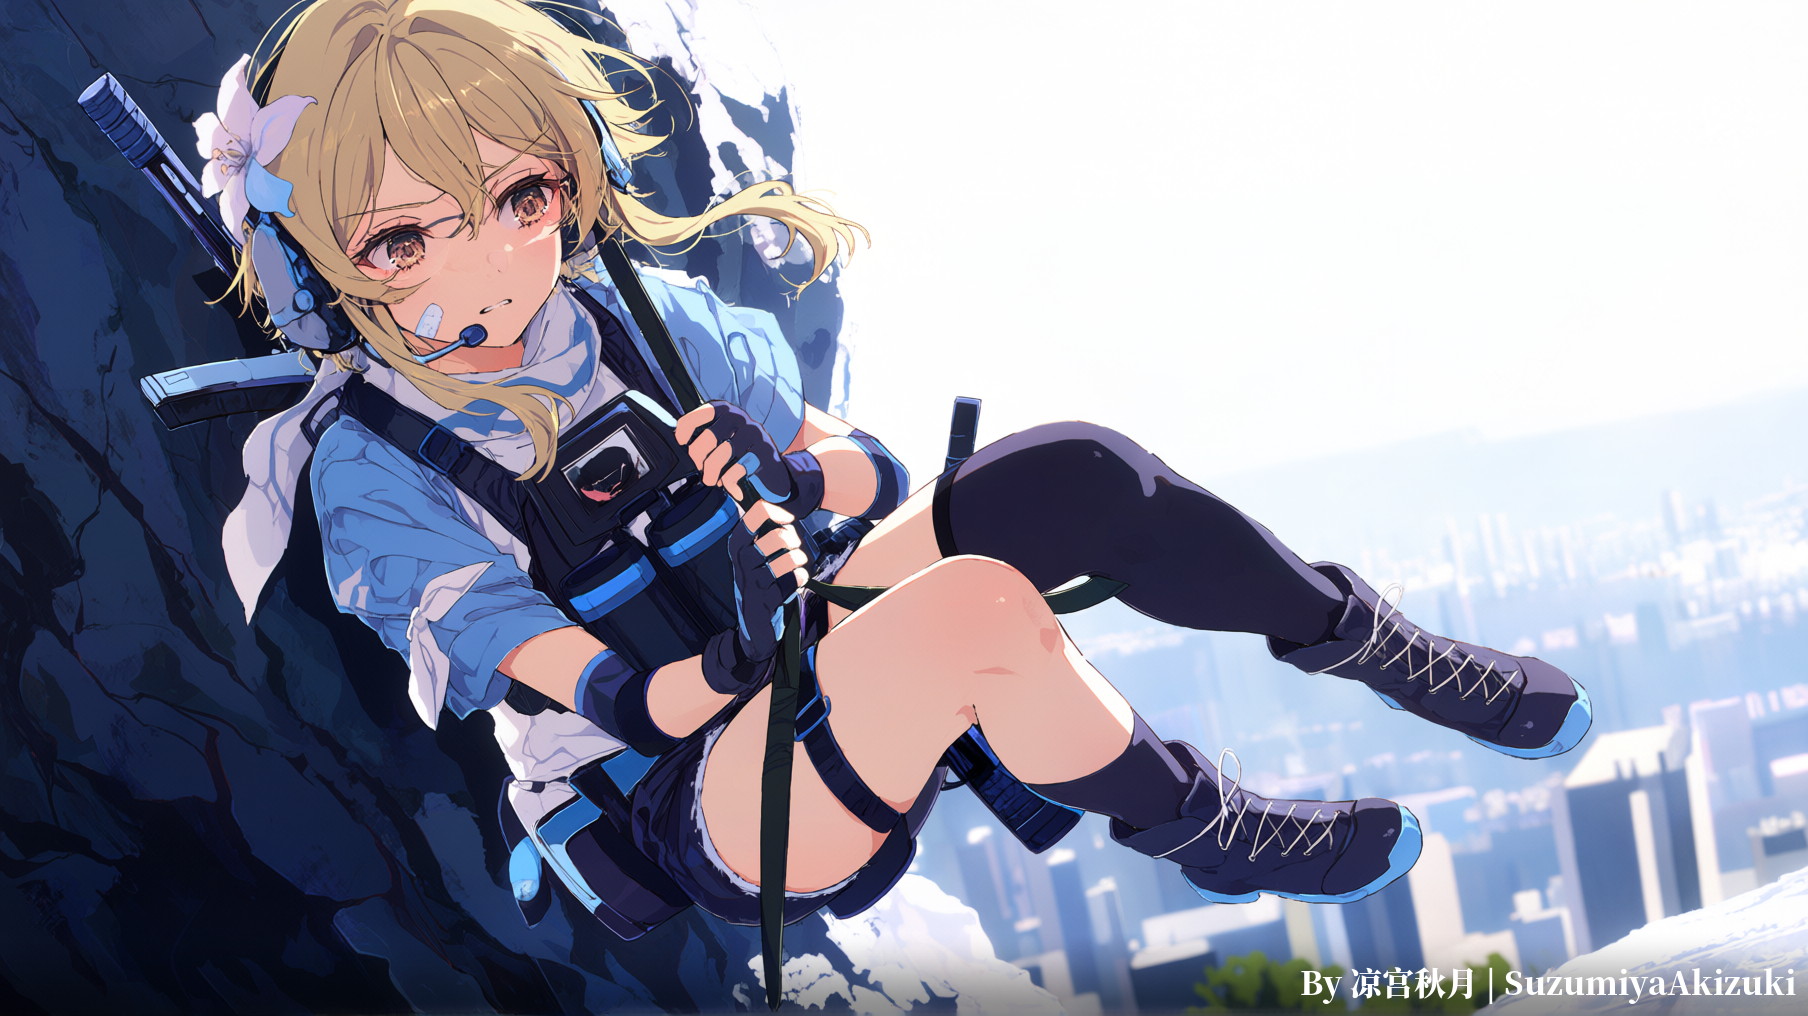
本模型是基于 circlestone-labs/Anima 的 Anima Base v1.0 训练的角色服装 LoRA,用于还原《原神》荧的「Elemental Warfare」造型。
该造型保留荧的金色短发、长侧发和白色花饰,搭配蓝白短袖上衣、白色围巾、深色短裤、蓝色腰带、露指手套、长短不对称的袜子及系带短靴。训练素材包含战术装备版与无护具基础服装版,并覆盖不同视角、表情和动作。
请注意:使用空格代替下划线,并使用反斜杠对小括号转义。
lumine \(elemental warfare\)
以下是推荐的提示词,可作为起始示例。
战术装备版:
lumine \(elemental warfare\), 1girl, solo, blonde hair, short hair, long sidelocks, brown eyes, hair flower, white flower, headset, white scarf, white shirt, blue sleeves, short sleeves, tactical vest, fingerless gloves, shorts, blue belt, thigh holster, kneepads, uneven legwear, thighhighs, kneehighs, lace-up boots, standing, full body, looking at viewer, simple background
无护具基础服装版:
lumine \(elemental warfare\), 1girl, solo, blonde hair, short hair, long sidelocks, brown eyes, hair flower, white flower, white scarf, white shirt, blue sleeves, short sleeves, fingerless gloves, shorts, blue belt, uneven legwear, thighhighs, kneehighs, lace-up boots, standing, full body, looking at viewer, simple background
模型规格
| 项目 | 详情 |
|---|---|
| 模型类型 | Anima LoRA |
| 底模 | Anima Base v1.0 |
| LoRA Rank / Alpha | 32 / 32 |
| 训练范围 | 仅扩散模型;不训练文本编码器 |
| 文本编码器 | Qwen3 0.6B Base |
| VAE | Qwen Image VAE |
| 保存精度 | FP16 |
| 输出格式 | SafeTensors |
训练参数
| 项目 | 配置值 |
|---|---|
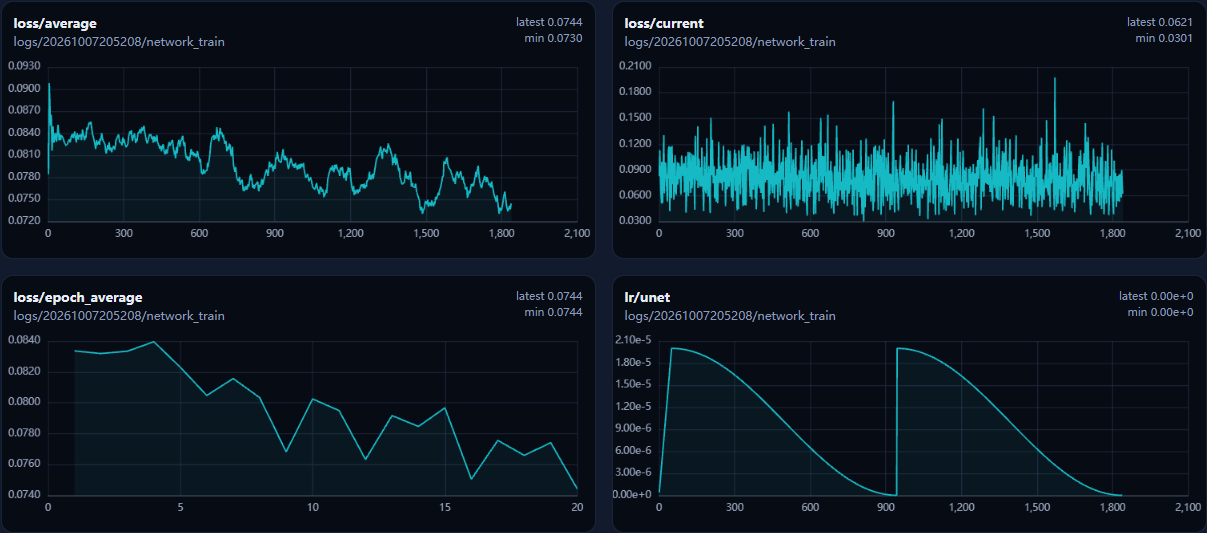
| 最大训练轮数 | 20 epochs |
| 批大小 / 梯度累积 | 2 / 1 |
| 优化器 | Automagic |
| 扩散模型学习率 | 2 × 10⁻⁵ |
| 学习率调度 | Cosine with Restarts |
| 调度周期数 / 预热步数 | 2 / 50 |
| 目标训练分辨率 | 1024 × 1024 |
| 分辨率分桶 | 开启;256–2048,步长 64,不放大输入图片 |
| 时间步采样 | Shift;Discrete Flow Shift = 3 |
| 水平翻转增强 | 开启 |
| 训练随机种子 | 1337 |
训练过程